量化戦略開発において、過去のK線データの欠損によるバックテストの偏差をどのように処理するか?
過去のK線データの欠損は、エラーを発生させずに移動平均やボラティリティ、売買シグナルを変化させ、バックテストに偏りを生じさせます。データ欠損の確認方法と信頼性の高い検証方法を解説します。
量化戦略の開発では、バックテストの結果に異常があっても、必ずしも戦略ロジックに問題があるとは限りません。より見落とされやすい原因の一つが、過去のK線データそのものの欠損です。
例えば、ある戦略がエントリーシグナルの判断に20日移動平均線を使用しているとします。過去データの途中で数本のK線が欠損していても、プログラムは通常エラーを発生させず、そのまま計算を続けます。しかし、戦略が認識している「20本のK線」は、実際にはより長い時間範囲に対応している可能性があります。その結果、移動平均、ボラティリティ、モメンタムなどの指標も変化します。
さらに厄介なのは、このような問題によってバックテストプログラムが停止するとは限らず、取引シグナルが気付かないうちに変化し、最終的にバックテスト結果の偏差につながることです。
数本のK線が欠けるとなぜバックテスト結果が変わるのか
過去のK線は単純な価格のリストではありません。多くの量化戦略では、各K線が指標計算や取引条件の判定に使用されます。
例えば、戦略が次のような計算を使用するとします。
MA20 = 直近20本のK線の終値の平均途中で3本のK線が欠損していても、プログラムは20個のデータポイントを取得したものとして、見かけ上正常なMA20を計算できる場合があります。しかし、この20個のデータポイントが実際にカバーしている時間範囲は変化しています。
同様の問題は、次のような指標や条件にも影響します。
- RSI、MACD、KDJなど、過去の一定期間を必要とする指標
- ATR、過去のボラティリティなどのリスク指標
- 過去高値のブレイクアウト、移動平均線のブレイクアウトなどの価格条件
- 連続したK線を前提とするトレンド判定
- 保有期間や取引シグナルの発生タイミング
そのため、バックテストで本当に確認すべきなのは「APIがデータを返したかどうか」だけではありません。データが完全か、時間が連続しているか、そして欠損が取引時間内に発生しているかを確認する必要があります。
欠損なのか、単に取引が行われていないのかを先に判断する
これは量化戦略開発で非常に混同されやすいポイントです。
1分足を使用している場合、夜間にデータがないからといって、それが過去K線データの欠損を意味するわけではありません。週末、祝日、取引所の昼休み、そして市場自体が取引を行っていない時間帯を、単純にデータ異常として扱うべきではありません。
本当に確認すべきなのは、
本来取引データが存在するはずの時間帯に、不自然な時間の空白が発生していないか?
という点です。
例えば、ある市場の通常取引時間内で次のようなデータが続いていたとします。
10:31
10:32
10:33
10:35
戦略が1分足を使用している場合、10:34についてさらに確認する必要があります。
一方、データが次のようになっていて、
11:59
13:00
対象市場が12:00~13:00に昼休みを設定しているのであれば、これは過去K線データの欠損ではありません。
そのため、バックテスト用データの検証では、単純に次のような条件だけを使用して異常を判定することはできません。
df["timestamp"].diff() > 1 minuteまず対象市場の取引カレンダーと取引時間帯を確認したうえで、その時間間隔が異常なのかどうかを判断する必要があります。
バックテスト前に最低限確認したい4種類のデータ問題
実用的には、戦略を実行する前にデータ品質チェックを追加し、異常を戦略そのものに処理させないようにする方法が有効です。
1つ目はタイムスタンプの問題です。
データが時間順に並んでいるか、重複したタイムスタンプが存在しないか、同一取引時間帯の中で不自然な時間のジャンプが発生していないかを確認します。
2つ目はOHLCの完全性です。
例えば、あるK線に始値と終値しかなく、高値や安値が欠けているケースです。戦略がATR、ボラティリティ、ブレイクアウト条件などを使用している場合、このような異常はシグナルに直接影響する可能性があります。
3つ目はデータの連続性です。
すでにK線が存在するはずだと判断できる時間帯について、データに欠損がないかを確認します。
4つ目は過去データの範囲不足です。
例えば、戦略が250日移動平均線を必要としているにもかかわらず、データセットに有効な取引日が180日しかない場合です。プログラムが手元にあるデータだけで計算を続けることはできても、それは戦略が本来必要としているバックテスト条件を満たしていません。
次の簡単なチェック関数を、バックテスト前のデータ品質チェックの入口として使用できます。
import pandas as pd


def validate_kline_data(df: pd.DataFrame):
    required = ["timestamp", "open", "high", "low", "close"]

    missing_columns = [
        col for col in required
        if col not in df.columns
    ]

    if missing_columns:
        raise ValueError(
            f"Missing required columns: {missing_columns}"
        )

    df = df.copy()
    df["timestamp"] = pd.to_datetime(df["timestamp"])
    df = df.sort_values("timestamp")

    # 重複したタイムスタンプ
    duplicated = df["timestamp"].duplicated().sum()
    if duplicated:
        raise ValueError(
            f"Found {duplicated} duplicated timestamps"
        )

    # OHLCの基本的な関係をチェック
    invalid_ohlc = (
        (df["high"] < df["open"]) |
        (df["high"] < df["close"]) |
        (df["low"] > df["open"]) |
        (df["low"] > df["close"])
    )

    if invalid_ohlc.any():
        raise ValueError("Invalid OHLC relationship detected")

    # 隣接するタイムスタンプの間隔をチェック
    gaps = df["timestamp"].diff()

    return {
        "rows": len(df),
        "start": df["timestamp"].min(),
        "end": df["timestamp"].max(),
        "max_gap": gaps.max(),
        "gap_count": int((gaps > gaps.median() * 2).sum())
    }
このコードは取引カレンダーの代わりにはなりませんが、重複したタイムスタンプ、異常なOHLC、明らかに不自然な時間間隔などを最初に抽出することができます。
本番環境のバックテストで使用する場合は、さらに市場ごとの取引時間に基づいて期待される取引時間のタイムスタンプ列を作成し、実際のK線と比較する必要があります。香港株やA株のように昼休みが存在する市場では、この処理が特に重要です。
「欠損した行を削除する」だけではデータ欠損を解決できない
これは、多くのバックテストスクリプトで発生しやすい問題です。
例えば、元のデータが次のようになっているとします。
09:30
09:31
09:32
09:34
09:35
異常なレコードをそのまま削除すると、残ったデータでもMAやRSIなどを計算できます。
しかし、問題そのものは解決していません。
戦略が各行を連続した1分足として扱う場合、09:34のデータは実質的に09:33の次のK線として誤って扱われることになります。
より適切なのは、欠損の原因に応じて処理を分けることです。
通常の休場時間である場合: 時間上の空白を維持し、価格を人工的に補完しない。
データソース側の欠損である場合: 該当区間を記録し、その区間をバックテストから除外するかどうかを判断する。
データ取得に失敗した場合: 補間によってK線を生成するのではなく、元のK線データを再取得する。
欠損によって指標計算に必要なウィンドウが不足する場合: 戦略に必要な最小履歴が揃うまで取引シグナルを生成しない。
OHLCデータについては、欠損したK線を作るために前の値を安易に引き継ぐ方法も特に推奨できません。前の終値を新しい始値・高値・安値・終値としてコピーすれば価格は連続しているように見えますが、ボラティリティ、出来高、ブレイクアウト条件などを変えてしまう可能性があります。
過去K線API自体もデータ完全性を左右する要素になる
過去データをAPIから取得する場合、APIがK線を返せるかどうかだけではなく、1回のリクエストでどれだけのデータを取得できるのか、そして取得した過去データをどのように継続的に保存するかも確認する必要があります。
AllTickのREST APIでは、単一商品のK線取得APIを提供しており、1回のリクエストで最大500本のK線を取得できます。株式K線では1分、5分、15分、30分、1時間、日、週、月などの周期に対応しており、株式では2時間足と4時間足には対応していません。
つまり、数年分のデータを使ってバックテストを行う場合、1回のAPIリクエストで返されたデータをそのまま完全な過去データセットとして扱うべきではありません。
より安定した方法は次のような流れです。
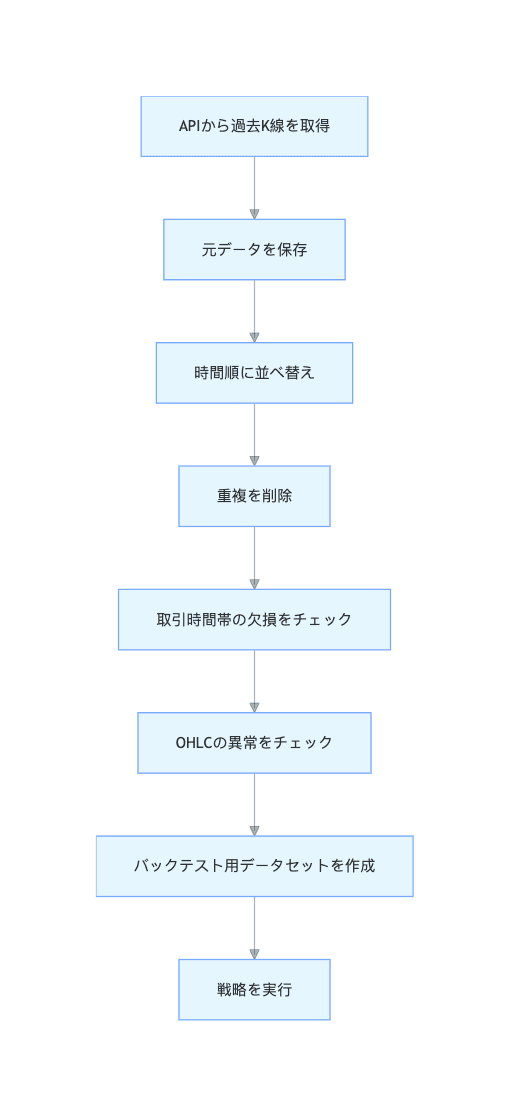
AllTickの公式開発資料でも、過去K線の取得とローカルデータの保存を組み合わせ、過去データを独自のデータセットとして構築する方法が案内されています。毎回バックテストのたびに過去データを再取得する方法ではありません。
戦略をテストするだけであれば、まず必要な範囲の過去データを取得してロジックを検証できます。しかし、本格的なバックテストに移行する場合は、検証済みのデータを永続的に保存しておくべきです。これにより、バックテスト結果の変化が「戦略コードの変更によるものなのか、それとも入力データの変化によるものなのか」を確認しやすくなります。
見落とされやすいもう一つの問題:過去データの期間不足
例えば、ある戦略が次のデータを必要としているとします。
250日移動平均線
+ 60日ボラティリティ
+ 20日モメンタム
この場合、必要なデータはバックテスト開始日から取得すればよいわけではありません。
例えば、バックテストを2025年1月1日から開始する場合、最初のバックテスト日に必要な指標を完全に計算できるよう、十分な過去データを事前に用意する必要があります。
そうしなければ、最初の数か月のデータが指標の初期化不足によってスキップされたり、異なる実装で異なる初期化方法が使われたりすることで、最終的にバックテスト結果に一貫性がなくなる可能性があります。
AllTickでは現在、プランによって利用できる過去K線の期間も異なります。公式料金ページでは、1年、3年、5年などの履歴期間が示されているため、データプランを選択する際には、戦略のバックテスト期間に対して十分な履歴が確保できるかを事前に確認する必要があります。
そのため、量化戦略開発では、過去データのカバレッジとK線の完全性を一緒に確認することが重要です。「データの期間は十分だが完全ではない」場合も、「データは完全だが履歴期間が不足している」場合も、どちらもバックテスト結果を歪める可能性があります。
データ品質チェックを戦略実行の前に置く
信頼性の高い量化バックテストの流れは、次のような単純なものではありません。
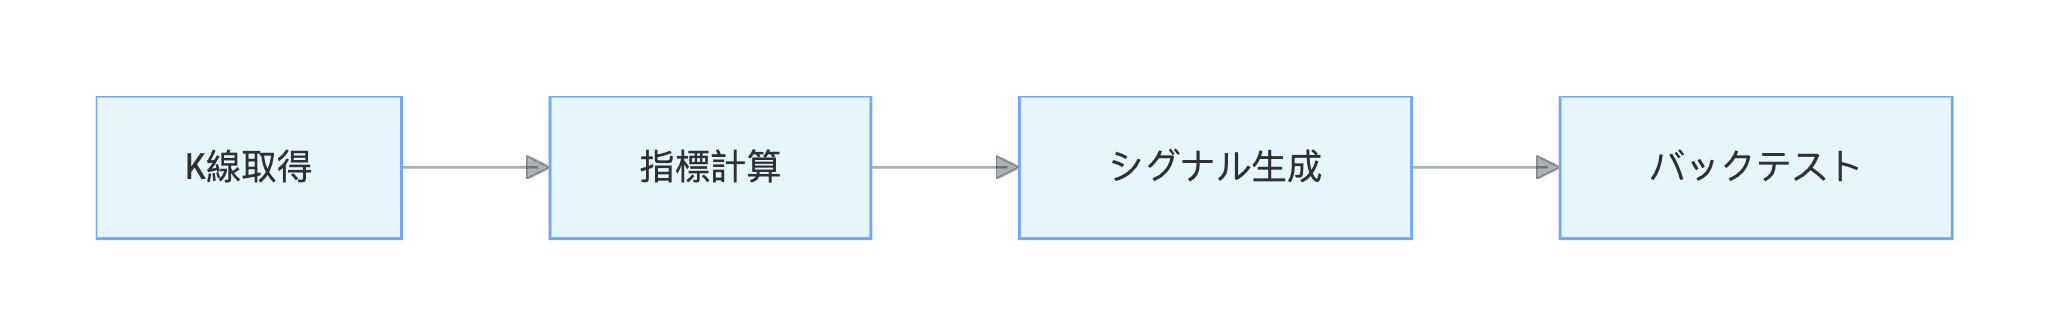
その前にデータ検証を追加する必要があります。
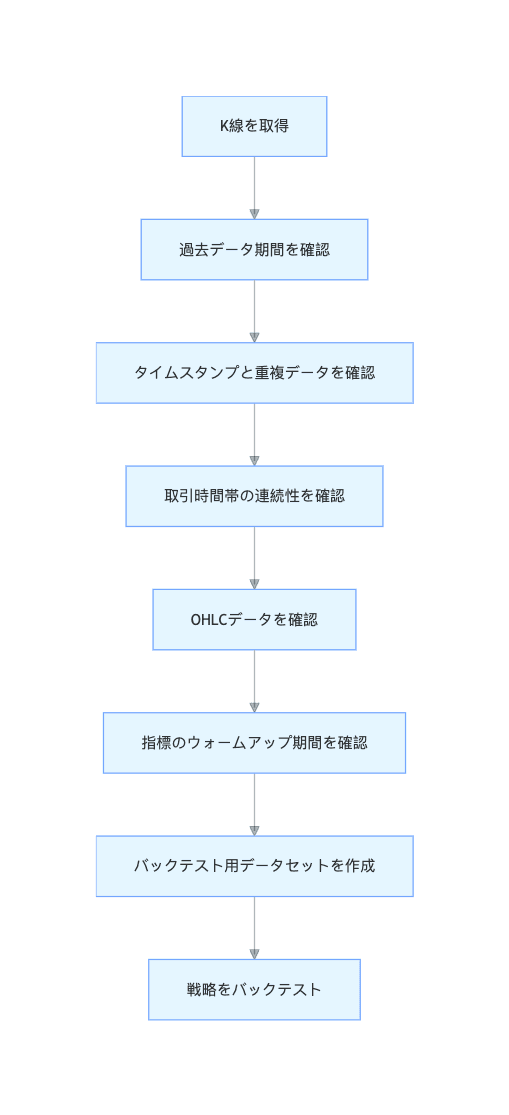
この方法の価値は、バックテストコードを複雑にすることではありません。「データの問題」と「戦略の問題」を切り分けられるようにすることです。
あるバックテストで収益率が突然20%から8%に変化した場合、開発者はまず、戦略ロジックが変わったのか、それとも入力データが変わったのかを判断できる必要があります。
複数市場の過去K線を取得し、量化戦略開発に利用する場合、AllTickは過去市場データを取得するためのAPIの一つとして利用できます。REST APIを使用して戦略に必要な銘柄と周期の過去K線を取得し、その後、自分のデータレイヤーで重複除去、完全性チェック、バックテスト用データ管理を行うことができます。
バックテストシステムを長期的に運用するデータパイプラインとして構築するのであれば、戦略の収益率に異常が出てから過去K線を調査するのではなく、まず「データが完全かどうか」を確認する仕組みから設計することをおすすめします。
さらに詳しいAPIパラメータ、認証方式、具体的なデータ範囲については、AllTick公式APIドキュメントを確認してください。